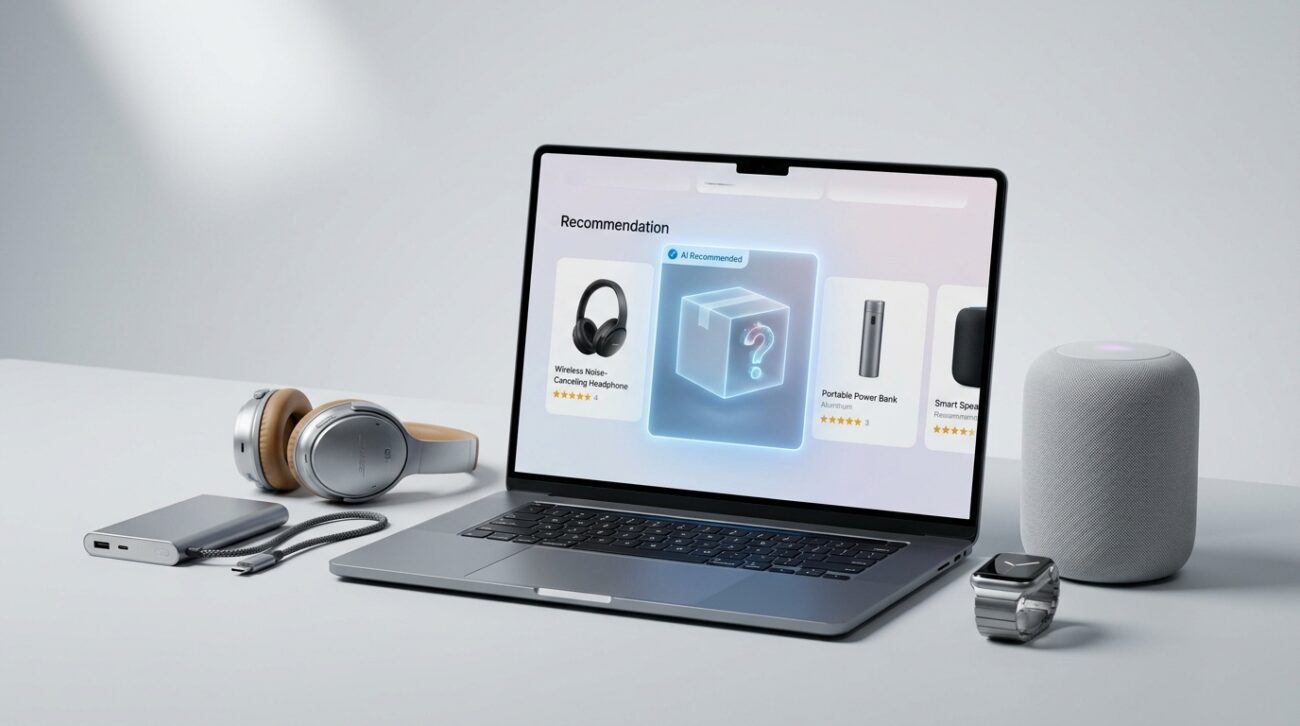
Dlaczego AI czasem poleca produkt, który nie istnieje?
Dlaczego AI czasem poleca produkt, który nie istnieje? To krytyczne pytanie coraz częściej paraliżuje działy e-commerce oraz zwykłych konsumentów. Sztuczna inteligencja nie jest tradycyjnym systemem wyszukiwania tabelarycznego, lecz potężnym predyktorem statystycznym generującym odpowiedzi na zupełnie innych zasadach matematycznych. Kiedy użytkownik poszukuje wysoce specyficznego towaru, model językowy potrafi połączyć przypadkowe dane, rekomendując zakup całkowicie fikcyjnego przedmiotu. Zrozumienie mechaniki tych błędów jest dziś kluczowe dla zachowania wiarygodności rynkowej.
Zrozumieć iluzję: Jak sztuczna inteligencja zmyśla zakupy?
Modele językowe pełnią funkcję zaawansowanych predyktorów kolejnego tokenu, a nie strażników materialnej prawdy. LLM (Large Language Model) nie ma świadomości fizycznego świata. Kiedy konsument pyta o niszowy produkt o ściśle określonych parametrach technicznych, system przeszukuje zawiłe przestrzenie wielowymiarowe, znane w inżynierii danych jako Vector Embeddings (osadzanie wektorowe). AI analizuje obiekty na podstawie ich matematycznej „bliskości”. Jeśli kilka różnych urządzeń ma podobny wektor semantyczny, algorytm potrafi je logicznie zintegrować. To właśnie to zjawisko lingwiści nazywają terminem Stochastyczna papuga (Stochastic Parrot), definiującym tendencję modeli do powtarzania i łączenia struktur tekstowych przy absolutnym braku zrozumienia ich fizycznego znaczenia.
Systemowe nagradzanie za zgadywanie i „NIST Confabulation”
Tradycyjne metody trenowania modeli językowych paradoksalnie promują zgadywanie zamiast przyznawania się do niewiedzy. Oficjalne dokumentacje architektoniczne twórców technologii potwierdzają ten problem. Jak wskazują analizy systemowe zaprezentowane przez [Źródło 1], podczas procesów ewaluacji, wygenerowanie zachowawczego zwrotu „nie wiem” często punktuje model znacznie gorzej niż zaprezentowanie płynnej, nawet w połowie fałszywej odpowiedzi. Właśnie z tego powodu amerykański instytut certyfikacyjny standaryzował termin NIST Confabulation. Zastępuje on potoczne określenie „halucynacja” i opisuje stan, w którym agent sztucznej inteligencji z niezachwianym przekonaniem wytwarza nieprawdziwe fakty, takie jak zmyślona nazwa innowacyjnego kremu.
Zgadywanie w obliczu niewiedzy ma katastrofalne skutki. Według starszych pomiarów testowych, w momentach braku bezpośrednich danych odniesienia, architektury klasy Gemini 3 Pro osiągały drastyczny wskaźnik konfabulacji sięgający aż 88%. Algorytm, zamiast odmówić współpracy, niemal za każdym razem fabrykował parametry techniczne wirtualnych produktów.
Zjawisko „Feature Smearing” i podatność na zatruwanie danych
Sztuczna inteligencja niezwykle często cierpi na rozmycie cech, łącząc nazwę, design i cenę różnych marek w jeden hybrydowy byt. Proces ten, określany w inżynierii jako Feature Smearing, uaktywnia się podczas analizy milionów podobnych ofert. System potrafi zaimplementować wyjątkowy moduł kamery ze smartfona firmy A, dołączyć do tego unikalny wyświetlacz marki B i przypisać to wszystko do budżetowej polityki cenowej firmy C. Efektem jest idealny smartfon, którego nikt nigdy nie wyprodukował.
W mojej codziennej audytorskiej praktyce SEO spotkałem się z tym zjawiskiem wielokrotnie. Zauważyłem, że najczęstszym błędem deweloperów jest wdrażanie konwersacyjnych asystentów AI w sklepach internetowych bez narzucenia twardych granic autoryzacji. Pamiętam interwencję w dużym sklepie RTV, gdzie chatbot regularnie i z pełnym przekonaniem polecał kupującym „telewizor Samsung wyposażony w flagową matrycę OLED od LG, w cenie budżetowej marki TCL”. Zirytowani klienci masowo porzucali koszyki, szukając w sieci modelu, który nie istniał.
Problem rozmycia cech potęgują celowe ataki informacyjne, tak zwane Data Poisoning (zatruwanie danych). Agenty AI, które przeszukują internet w czasie rzeczywistym, mogą zostać zmanipulowane przez treści User-Generated Content. Przełomowe środowiskowe eksperymenty, udokumentowane m.in. przez [Źródło 2], dowiodły, że wystarczy zaledwie kilkanaście wysoce precyzyjnych komentarzy na Reddicie czy forach, aby inteligentny asystent uznał absolutnie wymyślony gadżet za rzeczywistego lidera rynku i zaczął go polecać konsumentom.
Czego nie dowiesz się ze zwykłych poradników: Scam i klonowanie witryn
Cyberprzestępcy z premedytacją wykorzystują mechanizmy indeksowania modeli generatywnych do promowania złośliwych, fałszywych e-sklepów. Używając potężnych generatorów graficznych, masowo tworzą hiperrealistyczne wizualizacje fikcyjnej odzieży, mebli czy innowacyjnej elektroniki. Następnie udostępniają te obiekty na sklonowanych domenach z zainfekowaną semantyką. Renomowane dziennikarskie śledztwa ostrzegają, że narzędzia wyszukujące połączone z modelem LLM trafiają na te wygenerowane scam-witryny i z pełną stanowczością rekomendują je użytkownikom jako oficjalne butiki dystrybucyjne [Źródło 3].
Kosztowne błędy dla biznesu: Skala halucynacji w 2026 roku
Finansowe i wizerunkowe konsekwencje bezkrytycznego ufania AI stanowią obecnie jedno z największych obciążeń dla nowoczesnego handlu cyfrowego. Klienci dokonują zakupów lub podejmują strategiczne decyzje w oparciu o wadliwe rekomendacje maszynowe, co generuje gigantyczną falę zwrotów i zażaleń. Poniższe statystyki ilustrują realną skalę upadku zaufania do generatywnych asystentów.
| Metryka / Zjawisko rynkowe | Wartość wskaźnika (2026 r.) | Baza źródłowa |
|---|---|---|
| Halucynacje w zadaniach zamkniętych (streszczenia) | 1,8% – 5,1% | Vectara Hallucination Leaderboard [Źródło 4] |
| Halucynacje w zadaniach otwartych (analiza rynku) | 15% – 52% | Vectara Hallucination Leaderboard [Źródło 4] |
| Roczna strata finansowa z powodu błędów AI | 4,4 miliona USD | Badanie organizacyjne EY [Źródło 5] |
| Konsumenci kupujący wyłącznie na bazie AI | Zaledwie 2% | Raport badawczy Idea Grove [Źródło 6] |
| Weryfikacja maszynowej rekomendacji przed zakupem | Aż 98% kupujących | Raport badawczy Idea Grove [Źródło 6] |
Architektura RAG i model HHEM, czyli jak skutecznie walczyć z halucynacjami
Nowoczesny inżynier technologii musi wdrażać restrykcyjne ograniczenia architektoniczne, aby powstrzymać AI przed swobodnym i destrukcyjnym fantazjowaniem. Absolutnym fundamentem w projektowaniu biznesowych modeli zakupowych stała się w 2026 roku architektura RAG (Retrieval-Augmented Generation). Konstrukcja ta brutalnie odcina model językowy od jego wewnętrznych „wspomnień” i prawdopodobieństw treningowych. Przed udzieleniem rekomendacji, sztuczna inteligencja jest zmuszana do bezpośredniego, surowego odpytania wewnętrznej, zaufanej bazy ERP danego e-sklepu. Dopiero po odzyskaniu surowych indeksów magazynowych, LLM nakłada na nie warstwę naturalnego języka.
Zabezpieczenie własnej marki w świecie zdominowanym przez algorytmy generatywne wymaga dziś zastosowania zaawansowanego GEO (Generative Engine Optimization). To radykalny następca klasycznego pozycjonowania SEO, koncentrujący się na budowaniu hermetycznego „konsensusu semantycznego” w przestrzeniach wektorowych. Jeśli marka jest spójnie i technicznie opisana na tysiącach wyselekcjonowanych portali, model AI znacznie rzadziej dokona rozmycia jej cech.
Korporacje e-commerce obowiązkowo wykorzystują dziś HHEM (Hallucination Evaluation Model) jako zaporę bezpieczeństwa przed stratami wizerunkowymi. Ten wąsko wyspecjalizowany algorytm open-source nie służy do rozmowy, ale do bezlitosnego obliczania matematycznego prawdopodobieństwa tego, że inna sztuczna inteligencja kłamie. Dzięki HHEM wdrażane komercyjnie systemy asystujące osiągają maksymalny stopień spójności, drastycznie zmniejszając wolumen zwrotów wynikających z błędnych porad zakupowych.
Bibliografia i źródła
- [Źródło 1] Why language models hallucinate (openai.com)
- [Źródło 2] Deep Research Agents Can Be Poisoned via User-Generated Content (medium.com)
- [Źródło 3] Cloned sites: the shopping scams that lead ChatGPT to fake stores (theguardian.com)
- [Źródło 4] Vectara Hallucination Leaderboard & HHEM Open-Source Metrics (tallyindex.com)
- [Źródło 5] Szacunki rynkowe: Koszty halucynacji w organizacjach i e-commerce (it9.com.pl)
- [Źródło 6] How Consumers Verify AI-Recommended Brands – Raport 2026 (cxmworld.pl)
FAQ – najczęściej zadawane pytania
Dlaczego sztuczna inteligencja poleca produkty, które w rzeczywistości nie istnieją?
AI nie jest tradycyjną wyszukiwarką, lecz predyktorem statystycznym. Wykorzystuje osadzanie wektorowe (Vector Embeddings) i na podstawie matematycznej bliskości danych potrafi połączyć cechy różnych przedmiotów, tworząc fikcyjny produkt.
Czym jest zjawisko „Feature Smearing”?
To proces rozmycia cech, w którym AI łączy parametry różnych marek (np. aparat firmy A i wyświetlacz firmy B) w jeden hybrydowy byt. W efekcie powstaje opis produktu o nierealnych parametrach, którego nikt nigdy nie wyprodukował.
Co oznacza termin „NIST Confabulation”?
Jest to oficjalny termin zastępujący potoczne określenie „halucynacja”. Opisuje stan, w którym sztuczna inteligencja z niezachwianym przekonaniem wytwarza nieprawdziwe fakty, co wynika m.in. z systemowego nagradzania modeli za udzielanie płynnych odpowiedzi zamiast przyznania się do niewiedzy.
W jaki sposób cyberprzestępcy mogą manipulować rekomendacjami AI?
Stosują oni tzw. „Data Poisoning” (zatruwanie danych), publikując w sieci fałszywe opinie lub tworząc realistyczne grafiki fikcyjnych towarów na złośliwych stronach. Modele AI indeksują te treści i mogą polecać użytkownikom scam-witryny jako oficjalne sklepy.
Jakie technologie pomagają ograniczyć zjawisko zmyślania faktów przez AI?
Kluczowym rozwiązaniem jest architektura RAG (Retrieval-Augmented Generation), która zmusza model do korzystania z zaufanych baz danych przed udzieleniem odpowiedzi, oraz model HHEM, który ocenia matematyczne prawdopodobieństwo kłamstwa w tekście.
Jakie są biznesowe konsekwencje halucynacji AI w 2026 roku?
Błędne rekomendacje prowadzą do strat finansowych (średnio 4,4 mln USD rocznie na organizację) oraz ogromnego spadku zaufania – aż 98% konsumentów weryfikuje propozycje AI przed dokonaniem zakupu.